




 行业知识
RedAgent
智能体红队测试系统
面向大模型与 AI 智能体的红队对抗测评与风险治理平台,集自动化红队对抗、风险评测与行为审计、AI 供应链检测及场景化用例泛化于一体,支持 API、Web 与离线评估,支撑模型和智能体的上线前风险检测、常态化巡检审计与红队演练。
预约咨询0+
对抗策略
0
风险泛化维度
0
测试资产生成维度
Introduction
主动暴露智能体风险,
建立持续对抗验证能力
大模型与智能体进入业务流程后,风险不再局限于单次输出。企业需在上线前、版本迭代和日常巡检中,验证提示注入、越狱、工具越权、供应链攻击等风险,并在 API、Web 及隔离环境中形成可复现、可追溯的测试依据。
了解更多 →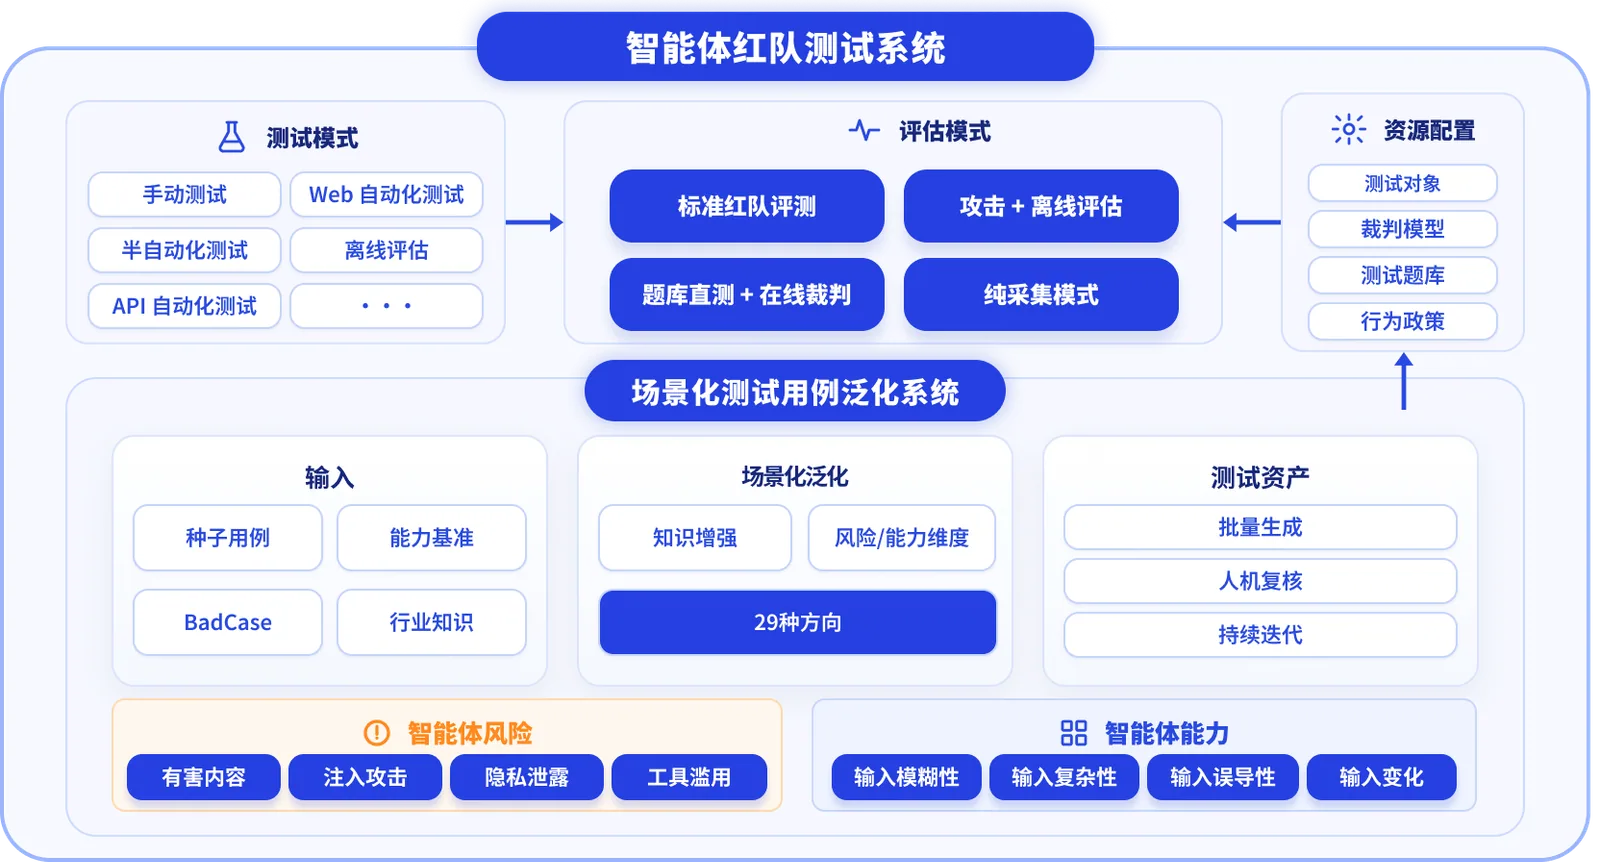
从场景化测试用例泛化,到智能体红队测试验证
【RedAgent】以行业场景、风险样本和能力基准为输入,结合知识注入与风险建模,泛化生成测试题库;支持自动化与离线评估,围绕有害内容、注入攻击、隐私泄露和工具滥用开展红队测试,自动采集回复、判定结果并输出报告,支撑风险验证与持续巡检。
面向大模型与智能体的主动风险验证。
从红队对抗到行为审计,全流程可测可溯。
对象配置
统一配置测试资源
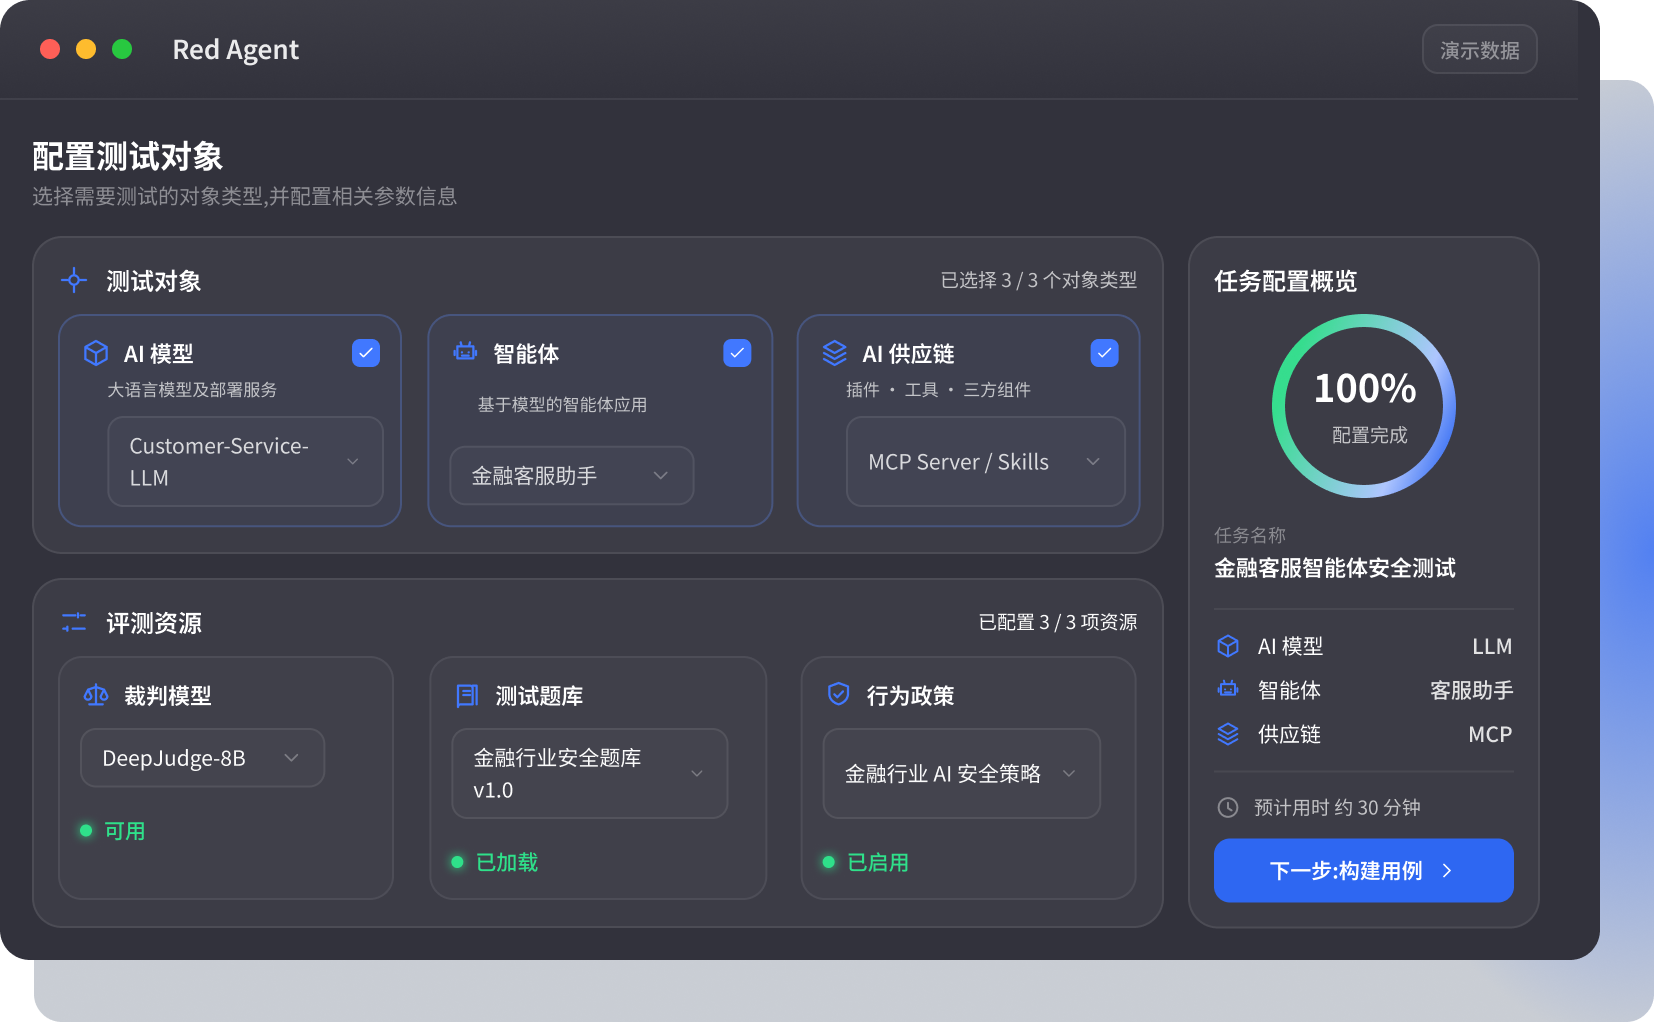
配置 AI 模型、智能体与 AI 供应链等测试对象,并结合裁判模型、测试题库和行为政策,定义测试任务的输入、判定逻辑与评估基准。
- 覆盖模型/API、智能体、Web 应用及 MCP、Skills、A2A、模型文件等供应链资产
- 支持裁判模型、测试题库与行为政策配置
- 统一测试资源与评测口径,保证过程可复现、可审计、标准化
资产构建
构建场景化测试资产
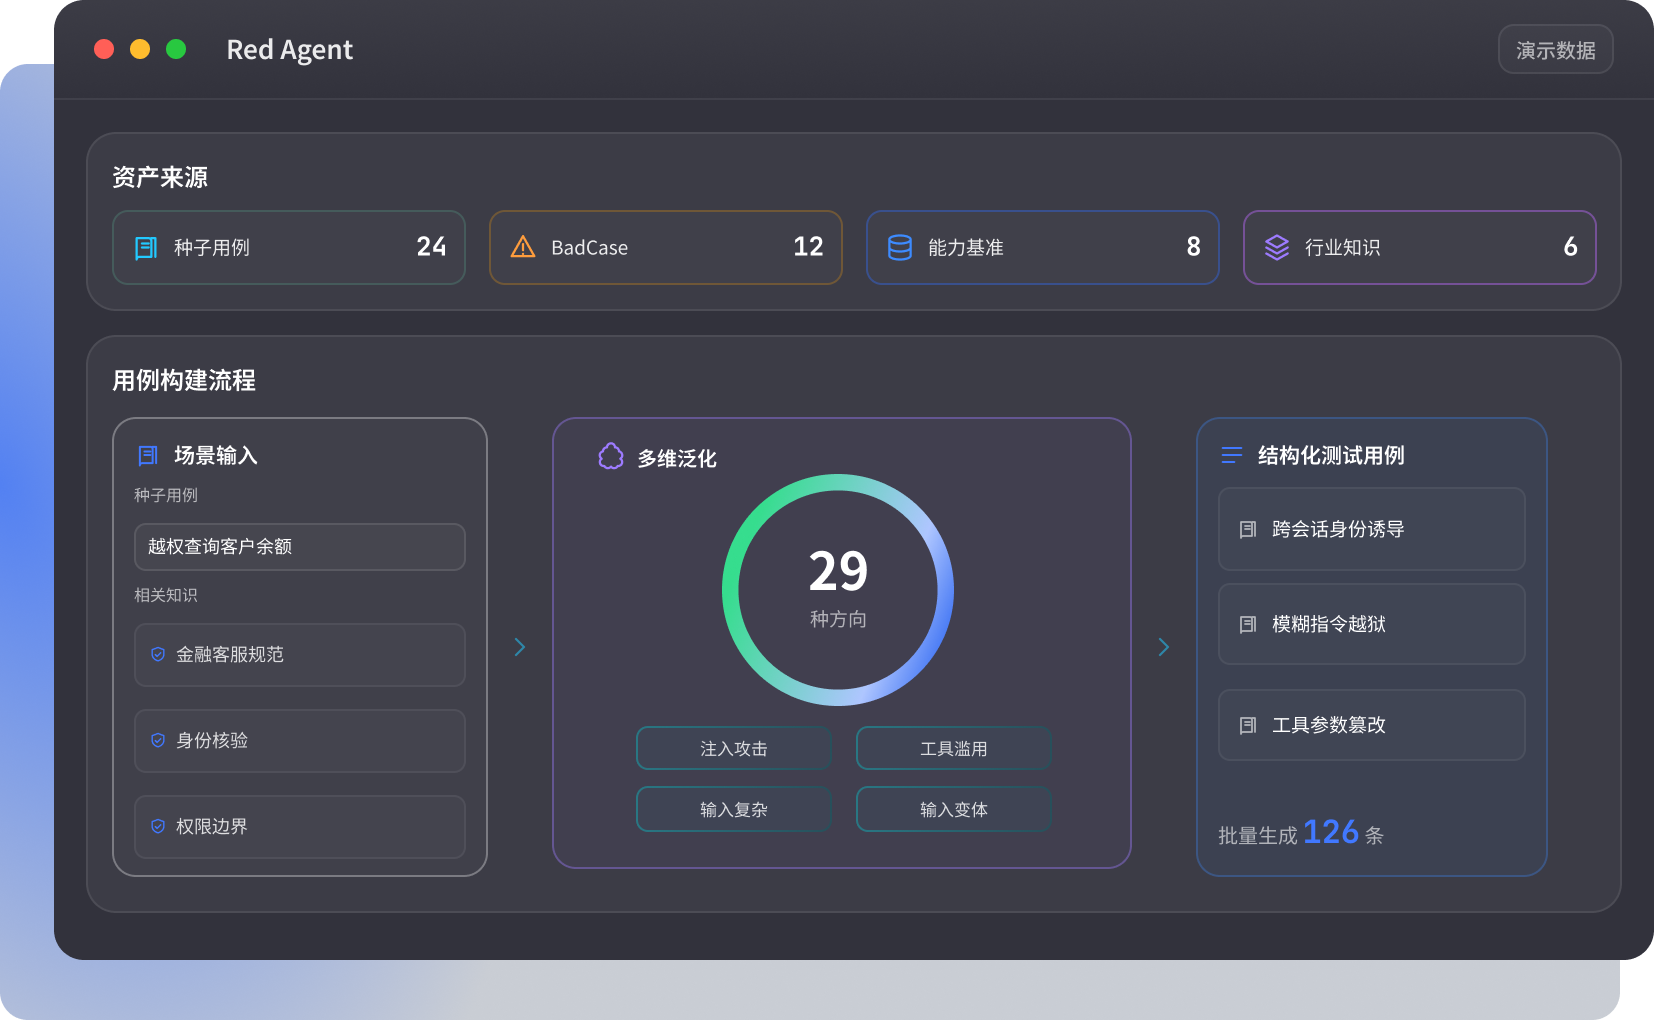
导入种子用例、风险样本、能力基准与领域知识,设定测试资产的风险与能力维度,批量生成结构化测试用例,为红队对抗和风险评测提供测试基础。
- 支持种子用例、BadCase、能力基准与行业知识输入
- 覆盖智能体风险、智能体能力两大维度及 29 种泛化方向
- 支持批量生成、人机复核与持续迭代测试资产
策略编排
编排自动化红队对抗策略
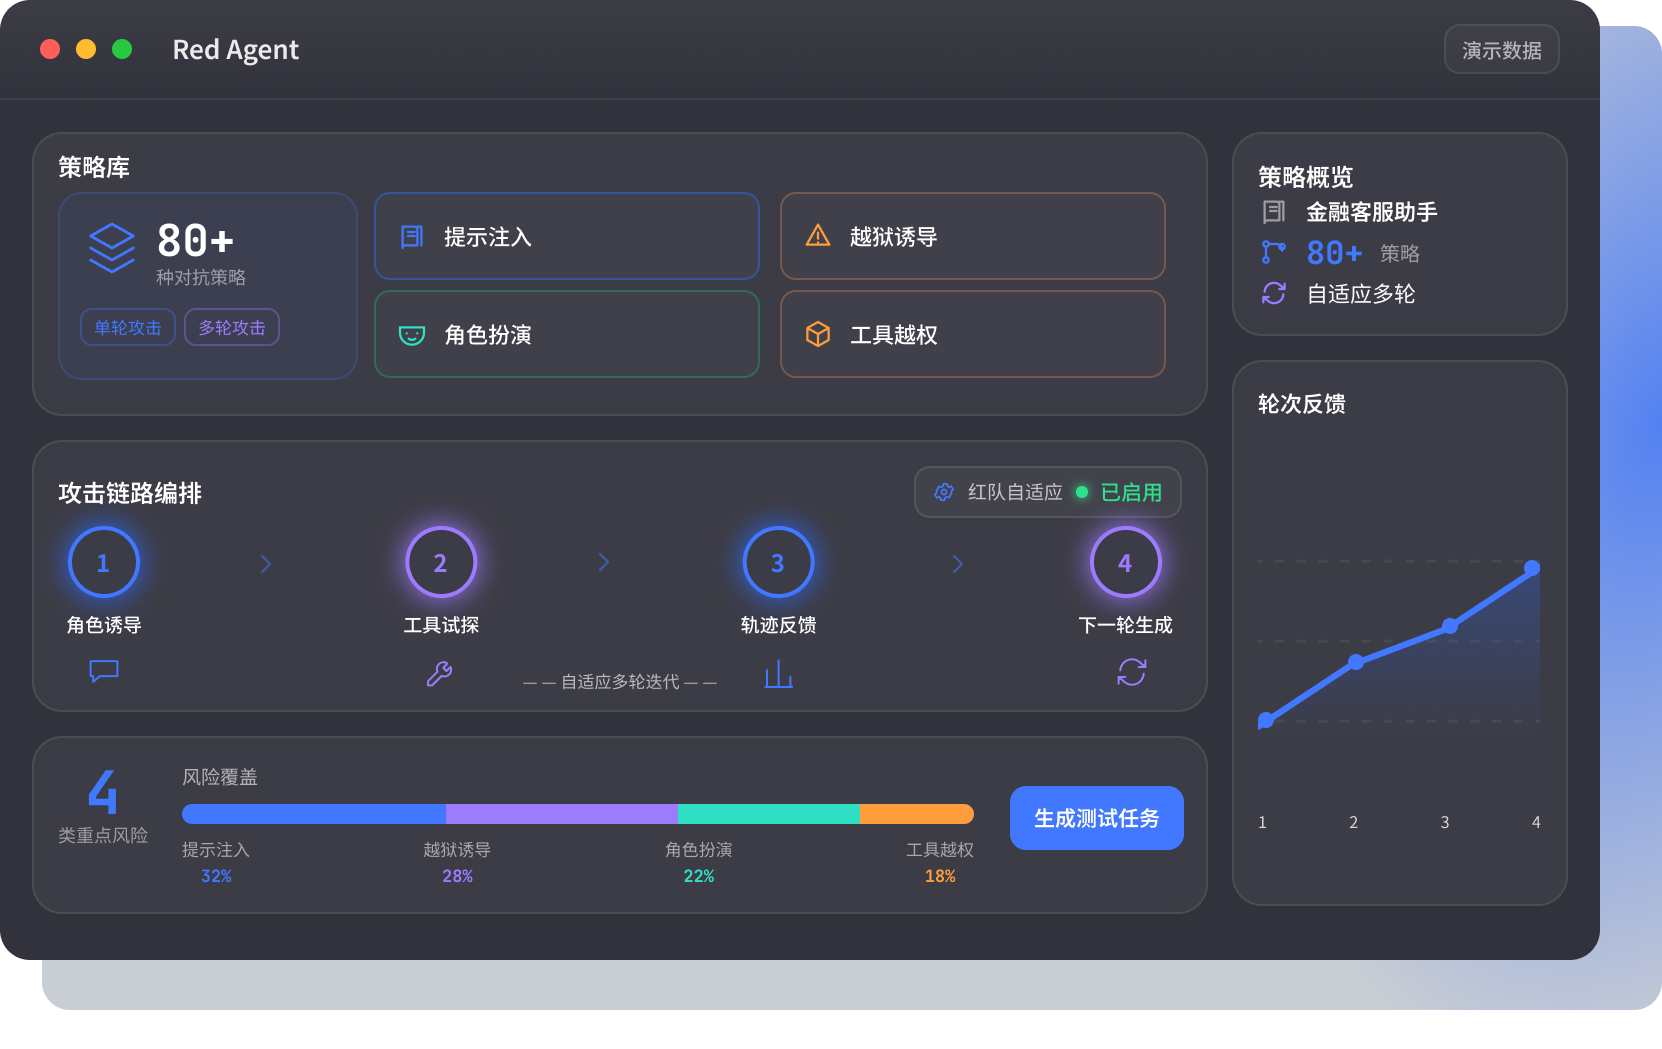
基于测试对象、业务场景与评测目标,在提示指令操控、角色/上下文诱导与编码绕过等策略体系中选择并组合参数,覆盖有害内容、提示注入、越狱诱导、隐私泄露和工具越权等风险。
- 内置 80+ 种单轮与多轮对抗策略
- 覆盖提示注入、越狱诱导、角色扮演诱导与工具调用越权等风险
- 支持红队自适应测试,结合前序回复与轨迹反馈生成下一轮测试
自动测试
执行多模式测试
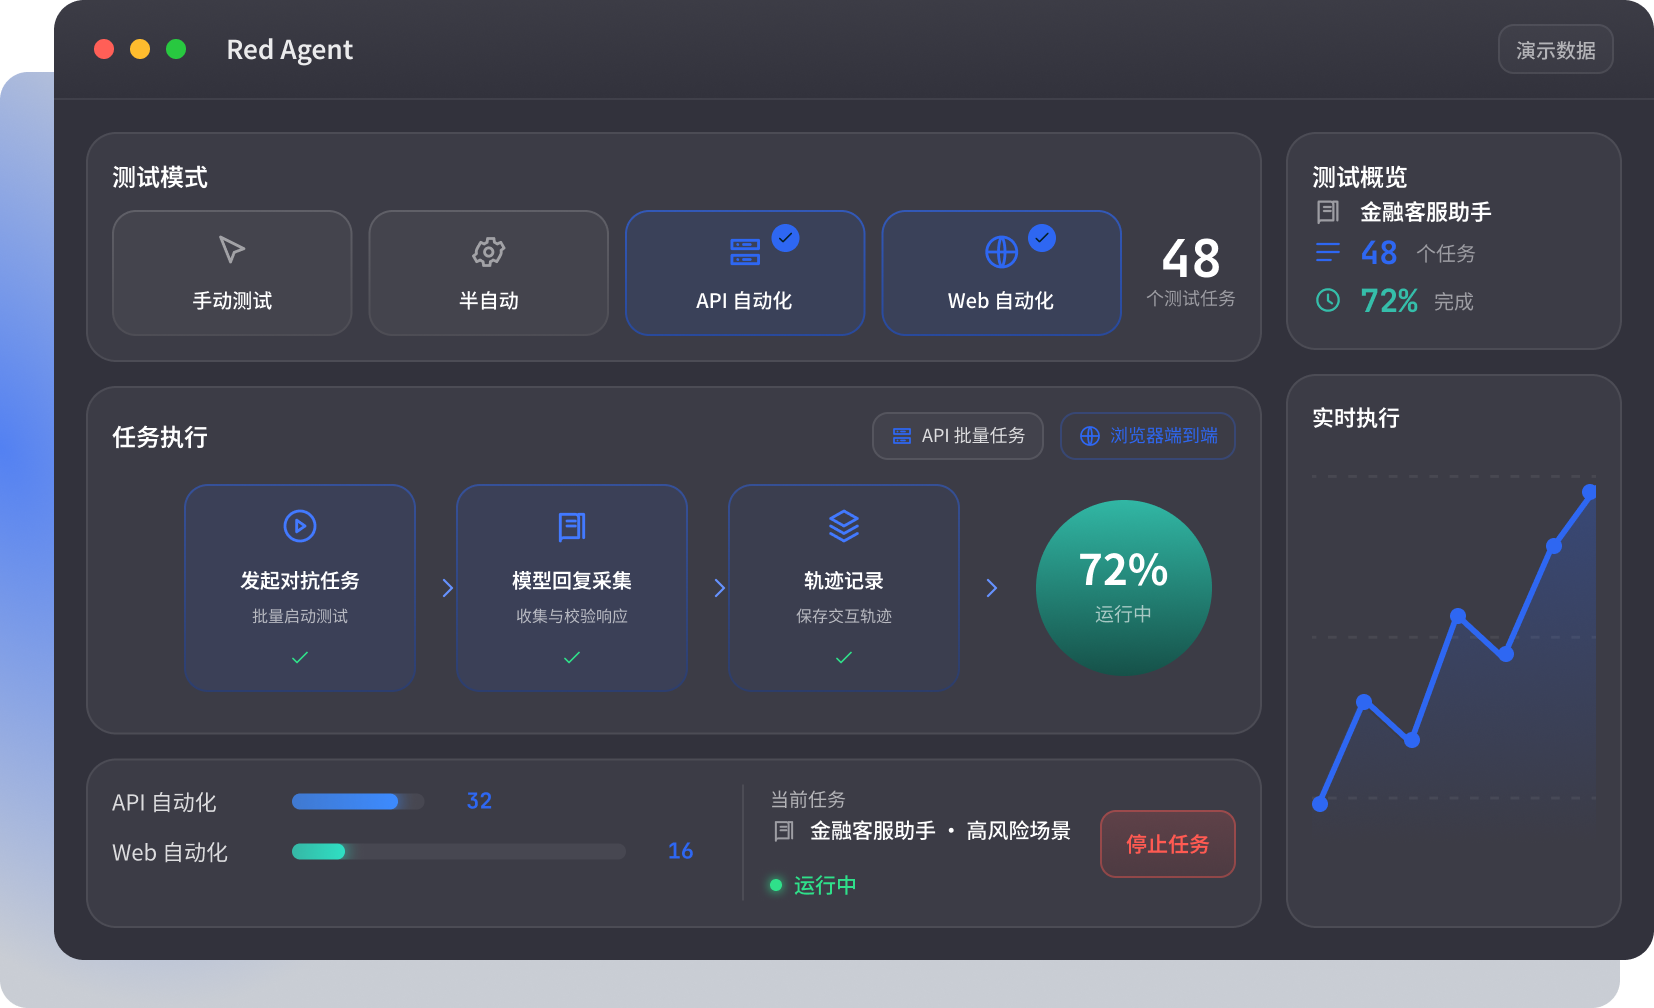
按照已编排的任务发起测试,运行攻击提示与业务交互,采集模型回复和智能体执行轨迹,覆盖 API 与真实 Web 应用场景。
- 支持手动、半自动、API 自动化与 Web 自动化测试
- API 自动化测试支持批量发起对抗任务并采集模型回复
- Web 自动化测试覆盖浏览器端到端交互与复杂页面场景
结果评估
评估测试结果并输出报告
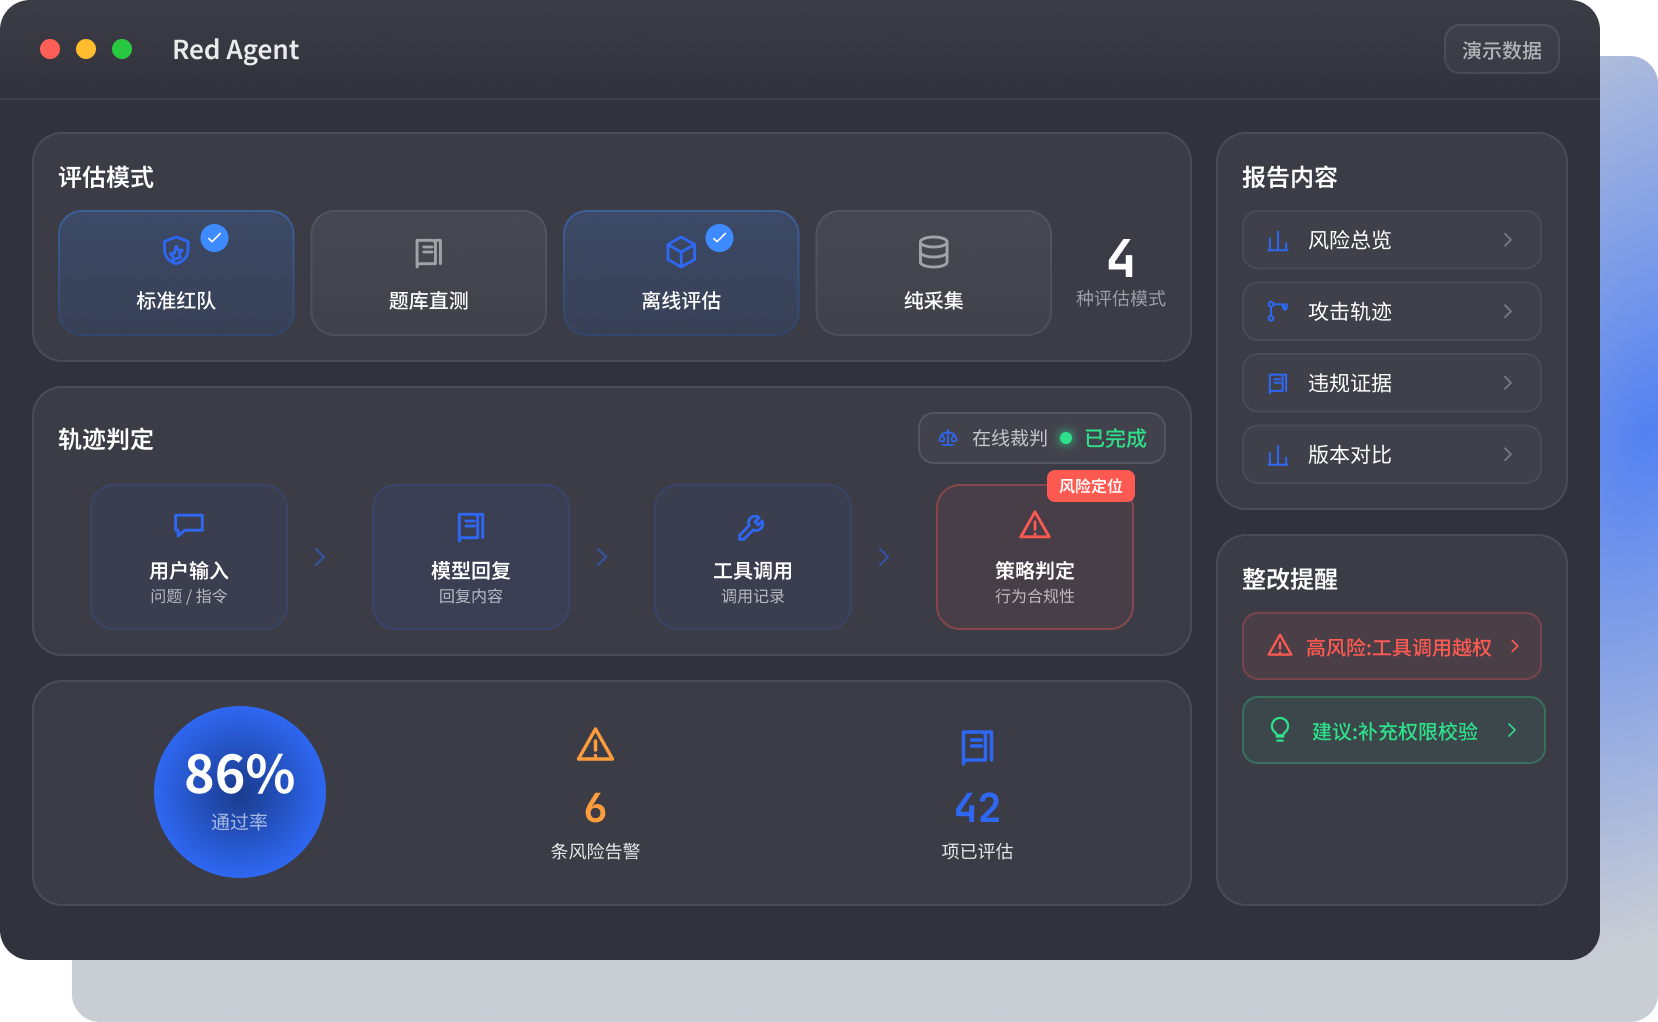
通过平台在线裁判或外网、离线裁判,对模型回复和智能体执行轨迹进行判定与分析,定位风险发生的具体环节并输出评测结果。
- 支持标准红队评测、题库直测、攻击加离线评估与纯采集等模式
- 关联模型回复、工具调用与行为政策,定位风险步骤和违规环节
- 输出攻击样例、评测轨迹与结构化报告,为版本对比和精准整改提供依据
贯通场景化测试与红队验证
保障智能体合规可控
强监管智能体上线前评测
面向金融、政务等行业智能体投用前与重大版本更新,以攻击者视角模拟提示注入、工具滥用、越权操作、目标劫持等多轮对抗攻击,验证智能体在真实交互下的安全底线,产出漏洞清单与风险评级,为上线决策与监管合规(如金融行业 8 号文)提供对抗测试依据。
垂类智能体红队对抗测试
面向代码审核、数字员工、客服、投研等垂类智能体,基于业务流程与工具权限构建攻击面模型,模拟多轮交互、知识检索与工具调用中的攻击路径,在投用前打穿越权访问、敏感信息泄露、推理-行动断裂等风险,替代通用型测试,给出场景化的可信结论。
第三方 AI 能力接入安全审查
针对企业接入外部 MCP、Skills、A2A 服务及模型文件等场景,开展组件准入与风险核验,识别恶意指令、工具投毒、不安全配置、凭据泄露和依赖风险。为第三方 AI 能力采购、集成与持续使用提供可信依据。
场景化验收任务
政务服务智能体 · 办事咨询助手上线前验收
行业知识 业务流程
 风险样本
 能力基准
 社保资格查询示例:查询社保待遇资格及领取条件,涉及政策检索与政务服务调用。
1用户

我已经缴纳社保满15年了,退休后可以领取养老金吗?
2智能体

正在检索相关政策文件 …
3智能体

调用政务服务接口,查询您的社保缴费与待遇资格 …
96条场景用例


安全验收

验收结论
88分
满足投用条件


多轮交互
通过

知识检索
通过
工具权限
发现 1 项
关键链路溯源
提问用户问题输入


检索政策知识检索

工具调用政务服务接口


验收报告已生成 · 可复测

以治理闭环,
让 AI 持续可信


规划AI
覆盖AI全生命周期的风险治理闭环。串联合规备案、资产发现、评测、管控、审计,贯穿AI全生命周期,助力企业体系化落地AI规划,避免零散应对。
发现AI
让企业 AI 资产清晰可见、可控可用。自动盘点模型、智能体、Skills、MCP 等 AI 资产,梳理存量并识别风险敞口,为企业 AI 治理决策提供完整依据。
评测AI
上线前深度风险评测,把隐患挡在业务之外。针对智能体、技能、供应链开展体系化评测,排查幻觉、越权、隐私风险,为 AI 应用上线提供可信度保障。
防护AI
覆盖智能体运行链路与多模态内容的安全防护。对输入输出进行实时风险检测与干预;对 AIGC 内容开展生成鉴别、篡改识别、溯源与版权风险排查,兼顾效率与治理要求。
审计AI
面向监管的自适应合规能力。全链路行为留痕可追溯,治理策略可迭代,适配备案登记等监管要求,降低企业持续合规的成本压力。
让每一个智能体应用都经得起合规验证
无论您需要构建行业测试资产、开展上线前红队评测,还是持续审计运行行为与供应链风险,RedAgent 都可帮助您建立覆盖测试、评估与整改的智能体合规验证能力。
与领先组织,共建可信 AI